9月18日,智谱正式上线GLM-5.3-FlashX,API同步开放。在GLM-5.3-Flash原有能力基础上,进一步提升推理速度。最高输出速度达到200 tokens/s,更适合AI Agent、代码生成、实时对话以及高频API调用等场景。
那GLM-5.3-FlashX性能怎么样?价格多少?和GLM-5.3-Flash有什么区别?下面一次讲清楚。
一、GLM-5.3-FlashX性能怎么样?
要了解GLM-5.3-FlashX,先看它的基础版GLM-5.3-Flash。
GLM-5.3-Flash于2026年8月上线并开源,320B总参数、18B激活参数(320B-A18B),是GLM-5系列首个原生多模态模型。据智谱数据,其Artificial Analysis Intelligence Index得分57,与Claude Opus 4.8持平;在Z.ai Code Bench中编程表现也与Claude Opus 4.8相当。可见它并非单纯低价轻量模型,而是在保持较强Coding、Agent和多模态能力的同时压低调用成本。
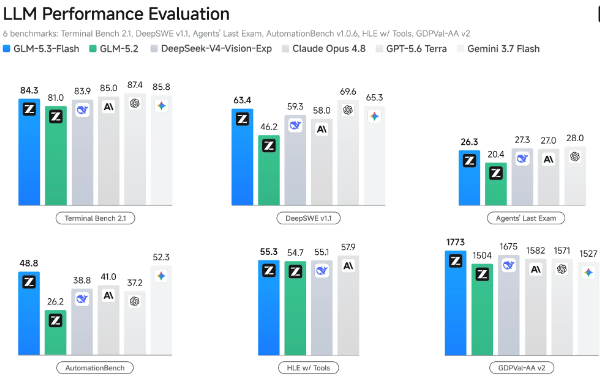
(图片来源:智谱)
GLM-5.3-FlashX可理解为GLM-5.3-Flash的高速版:能力基础基本不变,重点优化推理速度和调用体验。其最高输出速度达200 tokens/s,约为GLM-5.3-Flash的5倍。普通聊天中回答生成更快,对Coding Agent和自动化工作流提升更明显。
二、GLM-5.3-FlashX价格多少?
目前GLM-5.3-FlashX的API价格为:
输入:2 元/百万 Tokens
输出:7 元/百万 Tokens
缓存命中:0.57 元/百万 Tokens
作为对比,GLM-5.3-Flash输入为0.8 元/百万 Tokens,输出为2.8 元/百万 Tokens。
也就是说,FlashX的价格约为Flash的2.5倍,但最高输出速度提升到了约5倍。
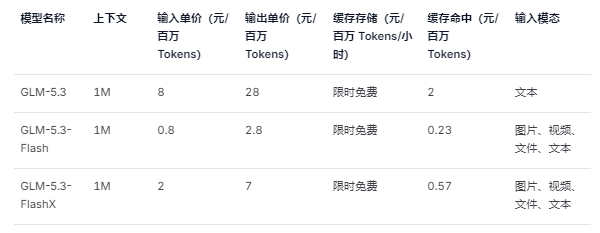
(图片来源:智谱)
因此两款模型的选择思路也比较清楚。
如果主要用于文章生成、资料整理,对速度要求不高,GLM-5.3-Flash的成本更低;如果用于AI Agent、Coding、高频API调用或者实时产品交互,GLM-5.3-FlashX更适合。
三、GLM-5.3-FlashX API怎么接入?
如何快速用上GLM-5.3-FlashX?可以使用OpenClaw部署助手配置。

 好评率97%
 下载次数:3620630
打开OpenClaw部署助手后,按照软件提示完成OpenClaw环境部署,不需要自己逐项安装和配置复杂的运行环境。
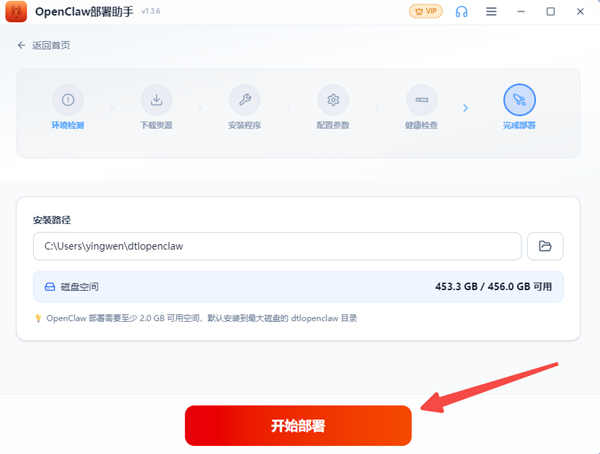
部署完成后,点击左侧的“AI模型”→“内置AI”。这里已经预置了DeepSeek、GLM、Kimi等超过25款主流模型,可以根据自己的需求选择对应模型并完成配置。
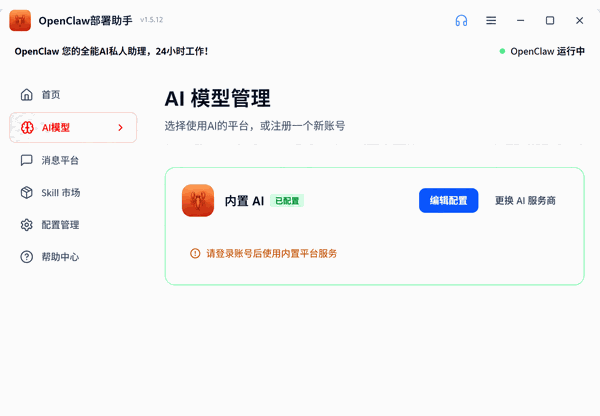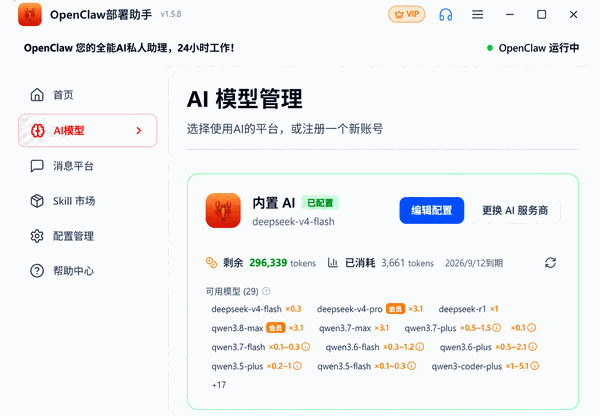
可选:如果需要通过API添加,则需要在“AI模型”中选择“智谱”,填写自己的智谱API Key,并将模型名称设置为:GLM-5.3-FlashX。
配置完成后,返回OpenClaw部署助手主页面,确认服务状态已经正常运行,然后点击“打开聊天”。
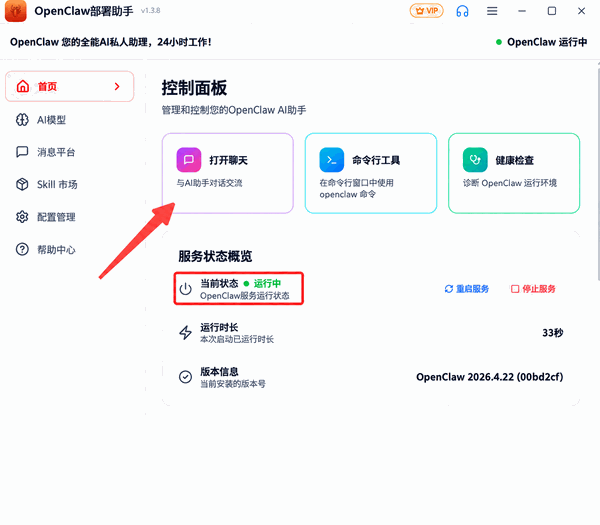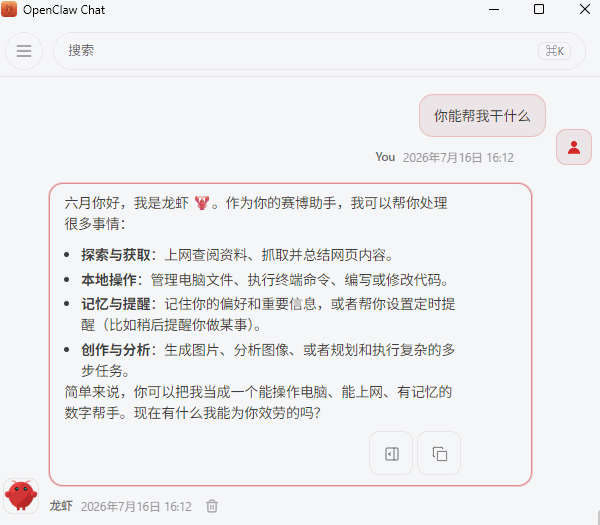
进入聊天页面后,可以先发送一条简单的测试消息,例如:“你好,请简单介绍一下自己。”如果模型能够正常回复,就说明GLM-5.3-FlashX已经成功接入。
GLM-5.3-Flash负责把模型能力和调用成本控制在较好的水平,FlashX则进一步解决推理速度问题。如果想要模型参与本地文件处理、工具调用和自动化任务,也可以通过OpenClaw部署助手进一步完成模型配置和AI Agent搭建。
最新资讯
 智谱GLM-5.3-FlashX模型上线:性能、价格及API接入教程
智谱GLM-5.3-FlashX正式上线,最高输出速度达到200 tokens/s。本文详细介绍GLM-5.3-FlashX性能、API价格、与GLM-5.3-Flash的区别,以及API接入教程。
2026-09-18 18:50:37lucky29257 Qwen3.8-Omni-Flash正式上线!附Qwen3.8快速部署配置教程
阿里千问9月18日正式上线Qwen3.8-Omni-Flash,这是一款原生全模态模型,支持文本、图片、音频和视频输入,并提供1M Token上下文。本文不绕复杂参数,先快速了解Qwen3.8-Omni-Flash的核心亮点,再通过OpenClaw部署助手配置Qwen3.8模型,适合刚接触AI Agent的用户快速上手。
2026-09-18 16:22:39Portia8596 《轮回保险公司R.I.P.》正式版发售:新角色凌、无尽模式及配置要求介绍
《轮回保险公司R.I.P.》1.0正式版正式上线,本文介绍新角色凌、无尽模式、新地图及配置要求,同时带来游戏运行异常和显卡驱动更新方法。
2026-09-17 10:19:44qwsa10253