最近,不少DeepSeek用户发现,原本可以持续使用的AI对话功能开始受到限制。11月16日,据IT之家报道,部分用户反馈DeepSeek App和网页版出现长对话限制、单次输入字数缩减以及每日使用额度限制等情况,系统给出的原因与算力不足有关。
对于习惯用AI写文章、处理文档、编写代码的用户来说,这无疑会影响日常工作效率。DeepSeek为什么会出现算力压力?云端AI使用受限后,有没有其他解决办法?
一、DeepSeek使用限制有哪些变化?
根据近期用户反馈,这次调整主要体现在三个方面:
1. 长对话功能受到限制
部分用户收到提示,因算力不足,超过7天没有活动的长对话不再支持继续使用。这意味着长期依赖同一聊天窗口保存工作上下文的用户,需要注意及时整理和保存重要内容。
2. 单次输入长度缩减
部分用户反馈,单次输入文字上限缩短至约4万字。对于经常上传长文档、分析大量资料的用户来说,可能需要拆分内容再进行提问。

图源:IT之家
3. 每日使用额度受到限制
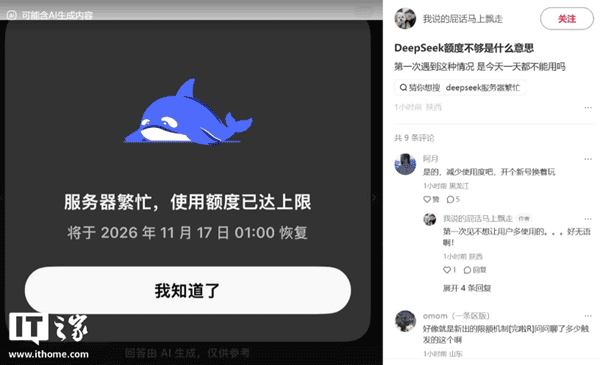
当日使用量达到上限后,页面可能出现“因服务器繁忙,使用额度已达上限”的提示,暂时无法继续正常对话。
二、DeepSeek为什么会面临算力压力?
AI大模型越来越普及,背后需要的计算资源也在不断增加。
以DeepSeek V4.1 Flash为例,据IT之家援引OpenRouter周榜数据,2026年10月19日至25日,该模型一周完成33.6万亿Token调用,环比增长801%,调用量增长十分明显。
与此同时,DeepSeek官方服务状态页面在10月至11月也记录了多次网页、API及对话服务性能下降或部分中断事件。
图源:IT之家
这说明大模型服务的需求增长与稳定性保障都面临考验。不过,目前还不能仅凭这些数据认定此次额度调整完全由某一个因素导致。
对于普通用户而言,一个现实问题已经出现:如果每天的工作都依赖同一个云端AI平台,一旦服务受限,就可能打乱原本的工作节奏。
三、DeepSeek使用受限怎么办?试试本地部署
与继续等待云端服务恢复相比,提前准备一个本地AI模型也是值得考虑的方案。
所谓本地部署,就是把模型文件下载到自己的电脑,利用本机CPU、内存和显卡完成模型推理。与直接使用网页版不同,模型部署完成后,不需要每次都向DeepSeek云端服务器发送推理请求。

 好评率97%
 下载次数:3790231
这里可以使用「160AI部署大师」。它支持DeepSeek、千问、Llama、Phi等模型的本地部署,将模型选择、下载和运行环境配置整合到可视化界面中,不需要用户手动编写复杂命令。具体操作:
1. 打开160AI部署大师,进入模型选择界面。
2. 找到DeepSeek模型分类,查看可选的本地模型版本。

3. 对照软件标注的CPU、内存、显卡及显存要求,选择适合自己电脑的模型。
4. 点击“立即安装”,选择模型存储位置。
5. 等待软件下载模型文件并完成运行环境配置。
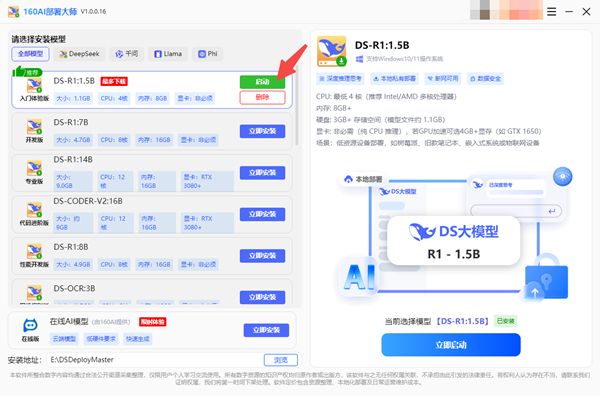
6. 安装完成后点击“启动”,等待模型加载。
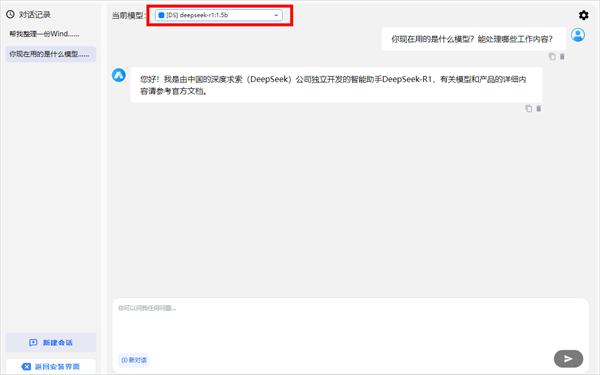
7. 进入AI对话界面,即可进行文本问答、内容生成等操作。
四、未来使用AI,云端和本地哪个更合适?
其实,两种方式并不是相互替代的关系。
云端AI的优势在于模型更新方便,不需要用户准备较高的本地硬件配置;本地部署则更适合希望降低对远程服务依赖、重视数据本地处理,或者需要在无网络环境下使用AI的用户。
如果只是偶尔使用AI聊天,网页版依然足够方便。
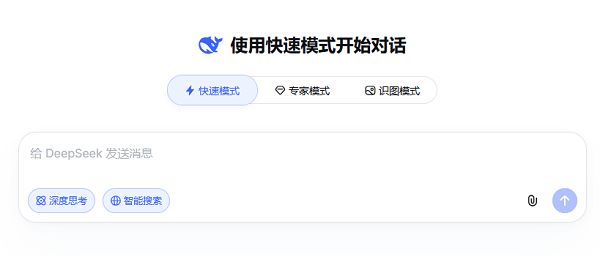
但如果每天需要大量使用AI,或者经常遇到服务器繁忙、额度不足等情况,准备一个本地模型作为备用方案,会更加灵活。
从这次DeepSeek使用限制来看,AI大模型的普及不仅需要更强的模型能力,也离不开稳定的算力资源支持。通过「160AI部署大师」将DeepSeek等模型部署到本地,可以为日常AI使用增加一种选择。云端负责便捷调用,本地负责备用和离线运行,两种方式结合,面对服务波动时也能更加从容。
最新资讯
 阿里最新Qwen4-Max来了!如何快速接入?这份教程建议收藏
阿里巴巴正式发布新一代旗舰大模型Qwen4-Max,支持超长上下文、原生视觉理解和复杂推理任务,在代码编写、智能体执行等方面进一步提升。想体验这款新模型,却不清楚如何接入?本文介绍通过OpenClaw部署助手的内置AI功能,一键选择Qwen4-Max,无需手动填写API Key,配置完成后即可进入聊天界面使用,还能查看账户剩余额度和使用记录,帮助新手快速上手。
2026-11-16 16:00:32Portia10011 DeepSeek算力不足开始限额?长对话和每日额度受影响,本地部署方案来了
DeepSeek近期再次受到算力压力关注。11月16日,有媒体报道称,部分用户反馈其App及网页版出现长对话限制、输入长度缩减和每日使用额度限制等情况。随着大模型调用需求持续增长,云端服务的稳定性也成为用户关注的重点。本文梳理此次DeepSeek使用限制的最新情况,并介绍通过160AI部署大师将DeepSeek模型部署到本地电脑的方法,让AI使用多一种选择。
2026-11-16 15:07:30Portia29810 谷歌发布Gemini 4 Hydrogen:编程速度提升2.5倍,百万Token上下文
谷歌正式发布Gemini 4 Hydrogen,主打高速执行、代码开发和AI智能体工作流,支持百万级Token上下文,并在多项编程及Agent测试中取得不错的成绩。本文整理Gemini 4 Hydrogen的核心功能、性能表现、API价格,并介绍如何通过OpenClaw部署助手配置该模型,体验新一代AI智能体能力。
2026-11-13 16:34:06Portia24888