国产大模型到底哪家强?这个问题没有标准答案,因为不同模型在不同任务上表现差异很大。本文选取DeepSeek、通义千问、Kimi、智谱GLM四大厂商的代表模型,通过五类任务实测对比,帮你找到最适合自己场景的国产大模型。所有测试均通过160 AI Router(airouter.160.com)的游乐场完成,一个平台测四款模型,省去了来回切换的麻烦。
一、测试设计:五类任务,四款模型
本次测试选取四款中端价位模型,能力定位接近,便于公平对比:
| 模型 | model参数 | 厂商 | 输入(积分/千token) | 输出(积分/千token) |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | DeepSeek | 240 | 960 |
| 通义千问 Plus | qwen-plus | 阿里巴巴 | 96 | 240 |
| Kimi K2.5 | kimi-k2.5 | 月之暗面 | 480 | 2520 |
| 智谱 GLM-5 | glm-5 | 智谱AI | 480 | 2160 |
五类测试任务分别为:文案写作、代码生成、逻辑推理、长文本摘要、多轮对话。每类任务使用相同的prompt,评估输出质量和响应速度。
二、文案写作能力对比
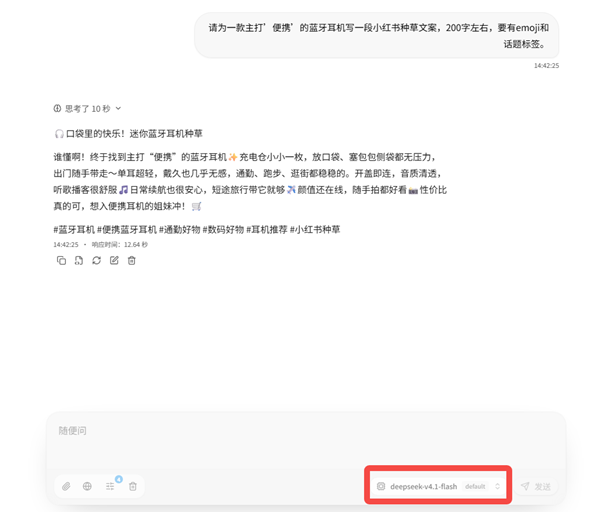
测试prompt:「请为一款主打'便携'的蓝牙耳机写一段小红书种草文案,200字左右,要有emoji和话题标签。」
| 模型 | 文案风格 | emoji使用 | 话题标签 | 综合评分(满分5) |
| DeepSeek | 网感强,情绪到位 | 丰富自然 | 有,5个 | 4.5 |
| 通义千问 | 规范工整,稍正式 | 适中 | 有,3个 | 3.5 |
| Kimi | 细腻走心,代入感强 | 丰富 | 有,5个 | 4.5 |
| 智谱GLM | 结构清晰,偏产品文案 | 较少 | 有,4个 | 4.0 |
结论:文案创作场景,DeepSeek和Kimi表现最好,网感强、情绪表达自然。通义千问偏正式,适合需要克制语气的品牌文案。
三、代码生成能力对比
测试prompt:「用Python实现一个函数,输入一个列表,返回其中出现频率最高的前3个元素及其次数。要求处理空列表和并列情况。」
| 模型 | 代码正确性 | 边界处理 | 代码风格 | 综合评分(满分5) |
| DeepSeek | 正确 | 处理了空列表和并列 | 简洁,含类型标注 | 5.0 |
| 通义千问 | 正确 | 处理了空列表 | 规范,含注释 | 4.0 |
| Kimi | 正确 | 处理了空列表和并列 | 清晰,附测试用例 | 4.5 |
| 智谱GLM | 正确 | 处理了空列表和并列 | 工程化风格,含docstring | 4.5 |
结论:代码生成场景,DeepSeek表现最佳,代码简洁且边界处理完整。智谱GLM的工程化风格也让人印象深刻,docstring和类型标注都很规范。Kimi额外提供了测试用例,适合需要快速验证的场景。
四、逻辑推理能力对比
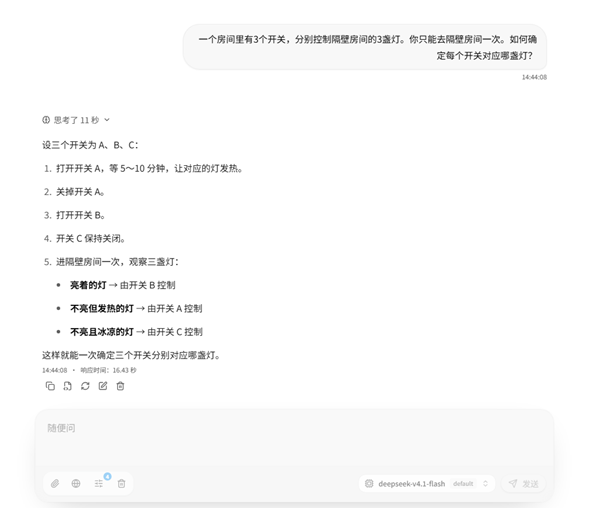
测试prompt:「一个房间里有3个开关,分别控制隔壁房间的3盏灯。你只能去隔壁房间一次。如何确定每个开关对应哪盏灯?」
| 模型 | 推理正确性 | 推理过程 | 表达清晰度 | 综合评分(满分5) |
| DeepSeek | 正确 | 分步骤推导,逻辑严密 | 非常清晰 | 5.0 |
| 通义千问 | 正确 | 推导过程略简略 | 清晰 | 4.0 |
| Kimi | 正确 | 详细推导,含排除法 | 清晰 | 4.5 |
| 智谱GLM | 正确 | 推导完整,有总结 | 清晰 | 4.5 |
结论:逻辑推理是DeepSeek的强项,分步推导清晰严密。四款模型都能给出正确答案,但DeepSeek的推理过程最令人信服。
五、长文本摘要能力对比
测试prompt:输入一段约3000字的文章(关于2025年中国新能源汽车市场分析),要求「用300字以内总结核心观点,分条列出。」
| 模型 | 要点覆盖率 | 字数控制 | 结构清晰度 | 综合评分(满分5) |
| DeepSeek | 覆盖主要观点 | 280字,达标 | 分条清晰 | 4.0 |
| 通义千问 | 覆盖大部分观点 | 310字,略超 | 分条清晰 | 3.5 |
| Kimi | 覆盖全面,含细节 | 295字,达标 | 分条,带小标题 | 5.0 |
| 智谱GLM | 覆盖主要观点 | 270字,达标 | 分条清晰 | 4.0 |
结论:长文本摘要是Kimi的绝对优势。要点覆盖最全面,结构最清晰,字数控制也最精准。如果你的应用涉及大量长文本处理,Kimi是首选。
六、多轮对话能力对比
测试方式:连续5轮对话,包含上下文引用、角色切换和追问修正。
| 模型 | 上下文记忆 | 追问修正能力 | 对话自然度 | 综合评分(满分5) |
| DeepSeek | 5轮内无遗忘 | 能根据修正调整 | 自然流畅 | 4.5 |
| 通义千问 | 5轮内无遗忘 | 能根据修正调整 | 自然,语气友好 | 4.5 |
| Kimi | 5轮内无遗忘 | 能根据修正调整 | 自然,细节丰富 | 4.5 |
| 智谱GLM | 5轮内无遗忘 | 能根据修正调整 | 自然,偏理性 | 4.0 |
结论:四款模型在5轮以内的多轮对话中表现接近,都能正确记忆上下文并响应修正。通义千问的语气最友好,适合客服类场景。
七、成本对比:同样的任务花多少钱?
把五类任务的输入输出token量统计后,对比各模型的单次任务成本:
| 任务 | DeepSeek(积分) | 通义千问(积分) | Kimi(积分) | 智谱GLM(积分) |
| 文案写作 | ~120 | ~34 | ~300 | ~264 |
| 代码生成 | ~360 | ~120 | ~520 | ~480 |
| 逻辑推理 | ~180 | ~50 | ~400 | ~360 |
| 长文摘要 | ~960 | ~300 | ~1980 | ~1740 |
| 多轮对话 | ~600 | ~170 | ~1280 | ~1140 |
| 五项合计 | ~2220 | ~674 | ~4480 | ~3984 |
通义千问Plus在成本上有压倒性优势——五项任务总花费仅为Kimi的15%。如果任务对模型能力要求不是特别高,通义千问Plus的性价比无可匹敌。
八、如何自己动手测?
以上测试全部通过160 AI Router的游乐场完成,你也可以用相同方式对比测试。操作步骤如下:
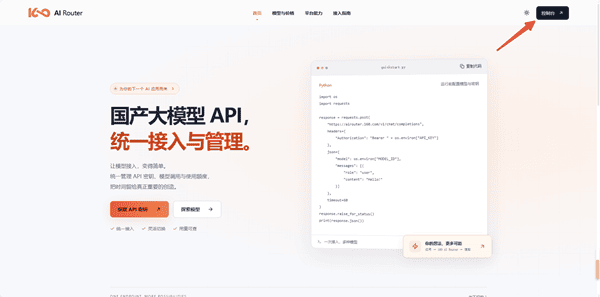
1. 打开160 AI Router官网,点击右上角「控制台」,扫码登录后进入。
2. 在控制台左侧导航「聊天」下点击「游乐场」。
3. 在输入框中输入你的测试prompt。
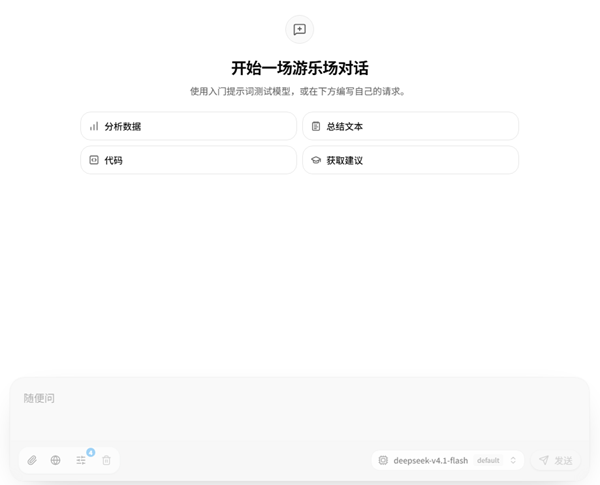
4. 在左下角下拉框中选择第一个模型(如deepseek-v4.1-flash),发送。
5. 记录输出结果后,点击「清空聊天历史」。

6. 切换下拉框选择下一个模型(如qwen-plus),输入相同prompt。
7. 重复以上步骤,对比四款模型的输出。
进阶:用代码批量测试
1. 在左侧导航「常规」下点击「API 密钥」,创建密钥。
2. 用OpenAI兼容SDK,循环调用四款模型。
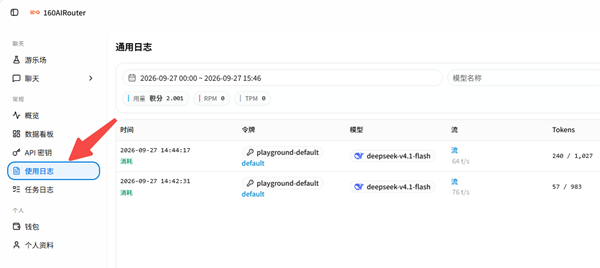
3. 在「使用日志」中查看每款模型的精确token消耗和费用。
4. 在「数据看板」中查看各模型调用详情。
九、总结与场景推荐
| 场景 | 首选模型 | 理由 |
| 代码生成与编程 | DeepSeek V4.1 Flash | 代码质量最高,边界处理完整 |
| 文案与内容创作 | Kimi K2.5 | 文笔细腻,网感强,细节丰富 |
| 长文本处理与摘要 | Kimi K2.5 | 长文本理解能力突出,摘要最全面 |
| 逻辑推理与分析 | DeepSeek V4.1 Flash | 推理过程最严密,分步清晰 |
| 客服对话与高频问答 | 通义千问 Plus | 语气友好,成本极低,适合大规模部署 |
| 智能体与工具调用 | 智谱 GLM-5 | 工具调用能力强,工程化风格好 |
没有“万能”的模型,只有“最合适”的模型。160 AI Router的价值在于:你不需要在四个平台分别注册测试,一个游乐场就能横向对比,一个密钥就能随时切换。建议先用游乐场用你的实际业务prompt测一轮,再根据效果和成本做最终选择。
常见问题
Q:为什么测试选这几款模型而不是旗舰款?
A:本文选择的是中端价位模型,在能力和成本之间取得平衡,更适合大多数实际应用场景。如果你想测试旗舰模型,可以在游乐场中选择deepseek-v4-pro、kimi-k3、glm-5.2等。
Q:游乐场测试消耗积分吗?
A:消耗。游乐场的调用与API调用一样按量计费。但通义千问Plus等模型价格很低,测试几轮的花费几乎可以忽略。建议先用低价模型测试prompt,确认后再用高价模型跑完整流程。
Q:怎么查看每款模型的详细参数和能力标签?
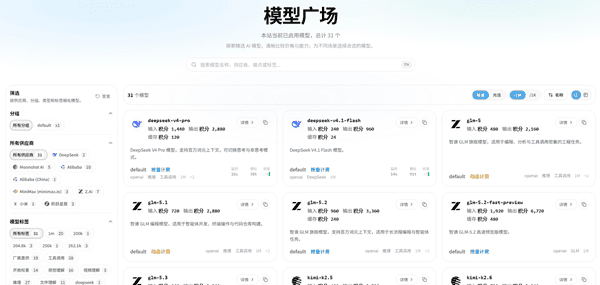
A:在「模型广场」页面,每款模型都有「详情」按钮,点击后可查看模型的能力标签(推理、工具调用、多模态等)、上下文长度和计费方式等详细信息。
最新资讯
 四大国产大模型硬核实测:DeepSeek、通义、Kimi、智谱到底谁更强?
本文选取DeepSeek V4.1 Flash、通义千问Plus、Kimi K2.5、智谱GLM-5四款中端国产大模型,通过文案写作、代码生成、逻辑推理、长文本摘要、多轮对话五类任务进行实测对比。每类任务附有具体测试prompt和评分表,并统计了五项任务的总成本对比。文章最后给出了6个典型场景的首选模型推荐,同时详细说明了如何用160 AI Router游乐场进行同样的对比测试,适合需要在不同国产模型之间做选型决策的开发者和产品经理参考。
2026-09-27 15:00:33Portia20167 多个大模型API怎么统一管理?160 AI Router接入OpenClaw教程
多个大模型API分散在不同平台,API Key、额度和模型配置越来越难管理怎么办?本文介绍通过160 AI Router统一接入多个AI模型,再使用OpenClaw部署助手完成API配置,让DeepSeek、Kimi、Qwen等模型真正进入可使用的AI助手环境。
2026-09-24 17:20:12kevin24071 大模型API中转网关怎么用?多模型统一接入教程
大模型API中转网关怎么用?如果DeepSeek、Kimi、Qwen等模型分别配置太麻烦,可以通过160 AI Router建立统一API入口,再接入OpenClaw部署助手,实现多个模型集中管理、切换和实际调用。
2026-09-24 17:19:39kevin20683