随着本地AI模型越来越成熟,通义千问(Qwen)也成为不少用户想要部署到个人电脑上的热门选择。相比在线AI工具,本地部署可以减少对云端服务的依赖,在模型和运行环境配置完整后,即使没有网络,也能进行日常问答、文本创作和代码辅助。
不过,很多新手在安装过程中容易遇到模型选择困难、运行环境配置复杂、硬件要求不清楚等问题。那么,通义千问怎么在Windows电脑上实现本地部署?本文将介绍两种实用方法,帮助你轻松学会。
一、通义千问可以在电脑本地运行吗?
可以。通义千问(Qwen)是阿里巴巴推出的开源模型系列,部分模型支持下载到本地电脑运行。部署完成后,用户可以直接在本地与AI进行对话,不必每次都通过在线平台调用模型。与在线AI工具相比,本地部署有几个比较明显的优势:
1. 数据隐私更好:本地运行的模型可以在不上传对话内容到云端的情况下处理任务。
2. 使用更加灵活:模型安装完成后,在断网环境下也可以运行。
3. 部署成本可控:不需要持续购买云端API调用额度,但需要考虑电脑硬件和存储空间成本。
不过,本地部署对电脑配置有一定要求,尤其是内存、CPU以及显卡显存。对于普通Windows用户来说,选择合适的模型版本非常重要。
二、部署前需要准备什么?
在安装之前,建议先检查电脑是否满足模型运行要求。不同版本的Qwen对硬件的要求有所区别:
| 模型版本 | 模型大小 | CPU要求 | 内存要求 |
| Qwen1.5B | 1.3GB | 4核 | 8GB |
| Qwen7B | 4.7GB | 8核 | 16GB |
| Qwen-coder7B | 约4.7GB | 8核 | 16GB |
| Qwen14B | 9GB | 12核 | 32GB |
*以上为参考配置,实际运行还会受到量化方式、上下文长度及其他程序占用的影响。
对于普通家用电脑,建议优先选择Qwen1.5B或Qwen7B。如果主要用于代码编写,可以考虑Qwen-coder7B;如果电脑拥有更充足的内存和显卡资源,再考虑Qwen14B。
三、通义千问本地部署两种方法
方法一:使用160AI部署大师一键部署
如果不熟悉Python、命令行以及模型运行环境的配置,可以借助160AI部署大师完成安装。它提供了模型分类和配置要求展示,不需要用户手动输入复杂的部署命令。具体操作步骤如下:
第一步:打开160AI部署大师
启动软件后,在首页可以看到多个模型分类,包括DeepSeek、千问、Llama和Phi等。
点击上方的「千问」分类,即可查看支持安装的通义千问模型。
第二步:选择合适的Qwen模型
根据电脑配置选择需要部署的版本。
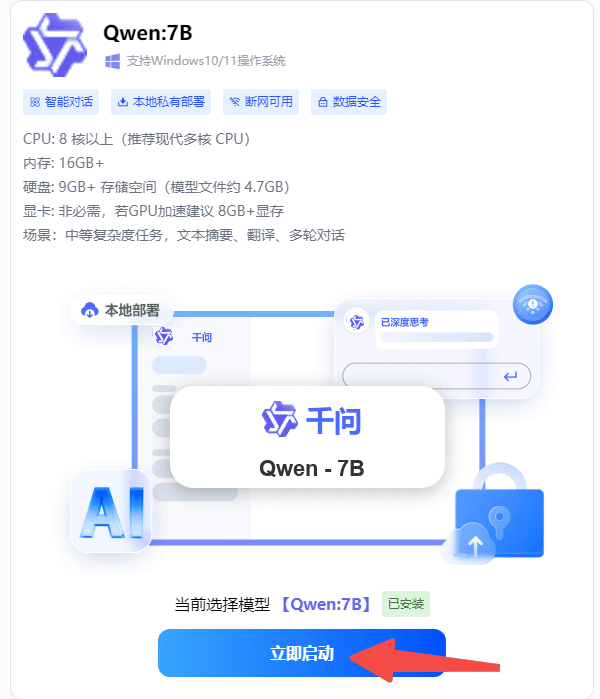
例如,电脑内存为16GB、CPU达到8核,可以优先考虑Qwen7B。软件界面会展示模型大小、CPU、内存以及显卡要求,可以根据这些信息进行选择。
如果电脑配置相对一般,也可以选择Qwen1.5B入门体验。

第三步:点击立即安装
选定模型后,点击右侧的「立即安装」按钮,等待软件完成模型文件下载及部署。
模型文件通常需要联网下载,建议提前预留足够的磁盘空间,并保持网络稳定。安装目录可以根据自己的实际需求选择,尽量不要放在剩余空间不足的系统盘中。
第四步:启动本地模型
模型安装完成后,回到对应模型页面。
此时可以看到当前选择的模型名称,确认安装状态正常后,点击下方的「立即启动」。
等待模型加载完成,就可以进入聊天界面。
第五步:进入聊天界面开始使用
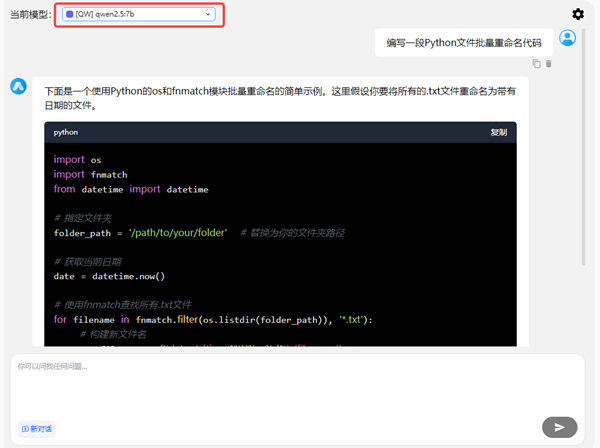
启动成功后,进入AI聊天界面,在输入框中发送问题即可与本地通义千问进行对话。
例如,可以尝试输入:
帮我总结一篇1000字的文章
编写一段Python文件批量重命名代码
分析这段代码存在的问题
帮我制定一份电脑学习计划
至此,通义千问本地部署就完成了。
方法二:通过Ollama手动部署通义千问
如果希望自己管理模型,也可以使用Ollama进行部署。这种方式需要手动安装运行环境,并通过命令行下载和启动模型。具体操作步骤:
1. 安装Ollama
下载并安装适用于Windows的Ollama,安装完成后打开命令提示符或PowerShell。
2. 下载通义千问模型
在终端输入对应模型的运行命令,例如:ollama run qwen2.5:7b。
这里以Qwen2.5 7B为例,具体可用模型标签及版本需要以Ollama模型库为准。
3. 等待模型下载
首次运行时,Ollama会自动获取对应模型文件。下载时间取决于网络速度和模型大小。
4. 开始本地对话
模型加载成功后,终端会进入交互界面,直接输入问题即可进行聊天。
这种方法适合有一定电脑操作经验的用户,如果不熟悉命令行,使用前面介绍的160AI部署大师会更加方便。
四、通义千问本地部署后如何离线使用?
不少用户部署本地AI,主要就是希望在没有网络的情况下也能使用。这里需要区分两个阶段:
① 首次部署阶段:通常需要联网下载模型文件以及相关运行组件。
② 日常使用阶段:模型文件完整下载、运行环境配置完成后,如果使用的是纯本地模型,就可以在断网状态下进行对话。

如果断网后无法正常启动,可以检查模型文件是否下载完整、运行组件是否安装成功,以及软件是否仍然需要联网验证或调用在线服务。
另外,本地模型的回答速度与电脑配置关系较大,运行时建议关闭不必要的后台程序,避免内存不足导致卡顿。
五、常见问题解答
1. 8 GB内存可以部署Qwen吗?
可以考虑160AI部署大师中标注为8GB内存要求的Qwen1.5B版本。不过,操作系统和其他程序也会占用内存,实际运行时可能需要关闭部分后台程序。

 好评率97%
 下载次数:3798851
2. 本地部署通义千问必须有独立显卡吗?
不一定。根据160AI部署大师界面展示,Qwen7B和Qwen1.5B均不强制要求独立显卡。不过,有GPU加速通常能够改善部分模型的运行体验。
3. Qwen7B和Qwen14B应该怎么选?
如果主要用于日常问答、文本总结,Qwen7B通常更容易满足普通电脑的部署需求。Qwen14B模型更大,对内存和计算资源的要求也更高,建议根据实际硬件情况选择。
最新资讯
 VC++运行库安装报0x80070643?修复方法
VC++运行库安装提示0x80070643、安装时发生严重错误?本文结合Visual C++ 2017报错实例,介绍运行库修复、版本检查、系统组件修复及安装日志排查方法。
2026-11-19 15:55:51kevin17365 通义千问本地部署怎么操作?Windows离线安装教程来了
通义千问(Qwen)支持在本地电脑部署运行,不依赖持续联网调用云端模型,也能满足日常AI对话、文本总结、代码辅助等需求。本文介绍Windows电脑部署通义千问的两种方法,包括使用160AI部署大师一键安装Qwen模型,以及手动部署的基本流程,帮助新手快速搭建本地AI环境。
2026-11-19 15:50:26Portia19571 VC++运行库x86和x64都要装吗?安装区别与建议
VC++运行库x86和x64有什么区别?64位Windows需要两个版本都安装吗?本文介绍VC++运行库的架构区别、正确安装方法及游戏程序报错的解决思路,避免装错版本。
2026-11-19 14:33:30kevin17258