Token作为大语言模型处理文本的最小计量单位,直接决定了你的AI调用成本。2026年,无论是DeepSeek、通义千问还是GPT系列,所有主流模型均采用按Token计费模式——输入Token和输出Token分开计价,且输出Token单价通常更高。很多用户发现月初额度充足,月中账单却触目惊心,根源往往在于对Token机制缺乏了解。本文将从Token原理出发,深入分析消耗过多的原因,并提供6个实用的节省方法,帮助你有效控制AI使用成本。
一、Token是什么?为什么消耗那么多?
在了解如何节省之前,先搞清楚Token的底层逻辑:
1. Token是模型处理文本的最小计算单元
LLM无法直接理解“字”或“词”,必须将文本拆解为Token并映射为数字ID才能计算。1个中文汉字约等于0.5–2个Token,1个英文单词约等于1.33个Token。
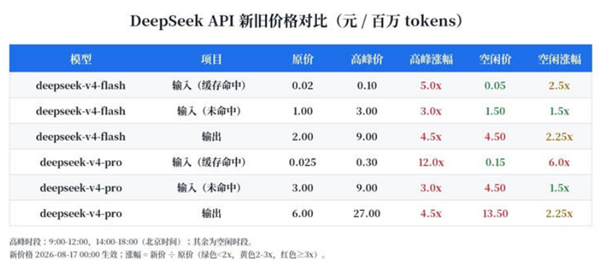
2. 输入与输出分开计费
一次API调用的总费用 = 输入Token数 × 输入单价 + 输出Token数 × 输出单价。输出Token因需逐个自回归生成,计算成本更高,单价通常是输入的数倍。
3. 上下文窗口隐性累积
模型每次回复都会重新读取当前对话的全部历史内容。随着轮次增加,输入Token快速累积,长对话的成本压力尤为明显。
4. 文件上传直接折算
上传的PDF、Word等文档会按内容长度全部折算为输入Token,一份10页文档可能一次性消耗数千Token。
二、有效避免Token消耗太多的7个方法
方法一:精简Prompt,用术语替代冗长描述
冗余的Prompt是输入Token浪费的主要来源。将长句描述替换为专业术语或缩写,可显著降低Token用量。操作步骤:
1. 删除不必要的礼貌用语和过渡词;
2. 用“JSON格式输出”替代“请你把结果整理成JSON格式返回给我”;
3. 对重复出现的概念定义缩写,如将“客户关系管理系统”统一替换为“CRM”。
方法二:控制对话长度,15–20轮后归档重启
长对话会导致历史上下文不断累积,每轮都重复计费。操作步骤:
1. 将单个对话控制在15–20轮左右;
2. 当对话较长时,将关键结论整理复制,新建对话粘贴核心信息后继续;
3. 关闭不再需要的历史对话,避免误用导致额外消耗。
方法三:合并子任务,避免重复加载同一上下文
把“先总结→再提炼→最后起标题”拆成三次提问,模型每一步都会重新加载全文,等于对同一资料多次计费。操作步骤:
将多个关联需求整合为一条指令,例如:“请总结这篇文章的关键结论,用3个要点列出核心观点,并给出3个标题备选“;
一次性加载上下文、集中输出多种结果,降低重复Token消耗。
方法四:使用OpenClaw部署助手内置AI功能
如果你同时使用多个AI平台,逐个注册账号、申请API key、填写配置不仅繁琐,还容易因配置错误导致重复调用或额度浪费。

 好评率97%
 下载次数:3679154
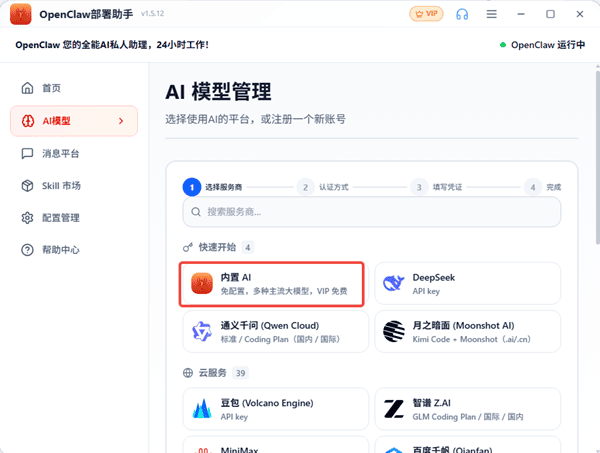
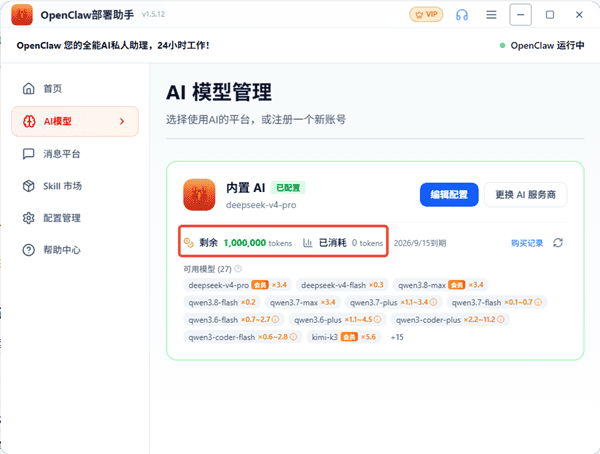
「OpenClaw部署助手」提供了内置AI功能,无需逐个去DeepSeek、通义千问、月之暗面等平台填写API key,直接选择”内置AI“即可使用deepseek-v4-pro、qwen3.8-max等主流模型,且VIP用户可免费使用。这种方式不仅省去了多平台管理的麻烦,还能通过统一的Token池和智能路由避免隐性浪费。操作步骤:
1. 打开OpenClaw部署助手,进入“AI模型管理”,选择“内置AI”;
2. 在下拉列表中选择适合当前任务的模型(如deepseek-v4-pro用于复杂任务,deepseek-v4-flash用于日常问答);
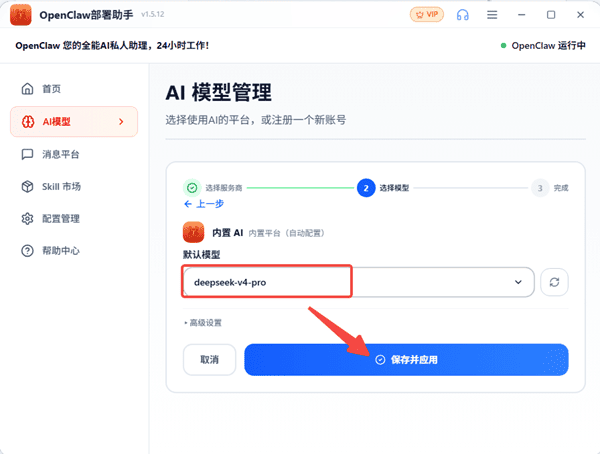
3. 点击保存后即可查看到该模型的token剩余量及消耗量。
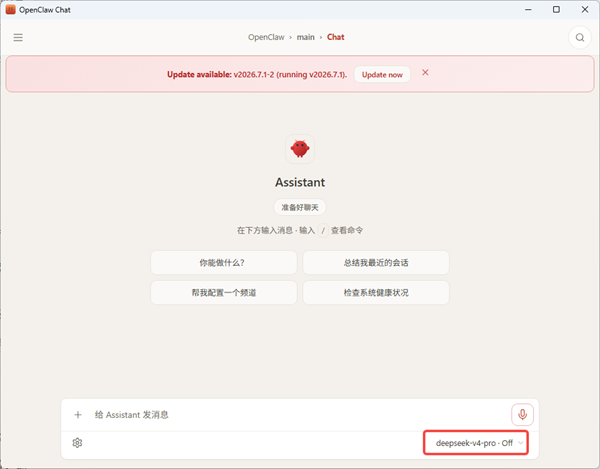
4. 配置完成后直接打开聊天界面,即可在Chat界面直接调用,无需额外配置API key。
方法五:按任务复杂度选择模型,避免大材小用
不同模型的Token单价差异可达10倍以上。日常简单任务无需调用最强模型。
| 任务类型 | 推荐模型档位 | 预估成本对比 |
| 日常问答、文本润色 | 轻量/Flash模型 | 基础成本的10–30% |
| 代码编写、逻辑推理 | 标准/Plus模型 | 基础成本的50–80% |
| 复杂架构设计、深度分析 | Pro/Max模型 | 基础成本100% |
操作步骤:
1. 简单任务使用轻量模型(如DeepSeek V4-Flash、Qwen-Flash);
2. 仅在复杂场景切换高性能模型;
3. 部分平台支持调整effort level,适当降低可减少“思考预算”。
方法六:利用缓存命中折扣与批量调用
2026年主流厂商已支持上下文缓存和批量调用折扣。操作步骤:
1. 对于重复性前缀(如系统指令、背景文档),利用Context Cache机制,命中缓存的Token可按原价10%计费;
2. 离线数据分析等非实时场景,使用Batch模式调用,价格通常为实时推理的50%。
三、常见问题解答
Q1:一个汉字到底算几个Token?
A:取决于分词算法和模型词表。主流中文模型中,1个汉字通常约等于0.5–2个Token,常见词汇如“人工智能”约等于2–3个Token。
Q2:怎么查看当前消耗了多少Token?
A:大多数AI平台在API返回结果中会包含usage字段,显示input_tokens和output_tokens。网页版用户可在账户中心的“用量统计”或“账单明细”中查看。
Q3:对话历史会消耗Token吗?
A:会。每次调用时,当前对话的全部历史都会作为输入Token重新发送给模型。这也是长对话成本飙升的核心原因,建议定期归档重启。
Q4:OpenClaw内置AI和自建API key有什么区别?
A:自建API key需要你在每个AI平台单独注册、充值、管理额度,配置繁琐且容易超支。OpenClaw部署助手内置AI由平台统一配置,用户无需填写任何key即可直接调用多种主流模型,降低了使用门槛和管理成本。
Q5:上传文件怎么节省Token?
A:上传前先用工具提取核心内容,删除页眉页脚、重复表格和无关附录;或将长文档分段上传,按需读取特定章节,避免一次性加载全文。
最新资讯
 Anthropic发布Claude Haiku 5.5:便宜到可以随便用,还能干编程
Anthropic发布Claude Haiku 5.5,运行成本较上一代降低约75%,每百万Token输入仅0.10美元。知识工作和电脑操作能力大幅提升,支持可调节性能模式。本文详解Haiku 5.5的价格、性能表现及适用场景。
2026-10-08 11:46:49lucky18836 Anthropic推出Claude Sonnet 5.5:速度提升30%,AI Agent能力升级
Anthropic正式发布Claude Sonnet 5.5,运行速度提升超过30%,代码、AI Agent和电脑操作能力进一步增强,同时API价格保持不变。本文介绍Claude Sonnet 5.5的主要升级、价格变化以及接入OpenClaw处理电脑任务的方法。
2026-09-29 15:00:55lucky28775 AMD核显天梯图2026最新版:从780M到8060S,一张表看懂排名
AMD核显近两年性能突飞猛进,Radeon 8060S甚至逼近RTX 4070移动版。本文带来2026年AMD核显天梯图解读:怎么看驱动人生官网的显卡天梯图、各代核显相当于什么独显、选购时要注意什么,并给出常见的问题解答。
2026-09-29 14:14:59Portia18646